跳表本质上是一个多层链表,底层链表保存所有元素,上层链表是下层的子集,通过这种分层索引结构把链表的 O(n) 查找优化到 O(logn)。
查找的时候从最高层开始,先往右走,遇到比目标值大的节点就往下走一层,重复这个过程直到找到目标或确定不存在。比如查找 50,从顶层的 10 开始,跳到 40 发现比 50 小继续往右,发现下一个是 70 比目标大,就往下走一层,在第二层从 40 往右一步就找到 50 了。
插入的时候,先用查找的方式定位到插入位置,然后随机决定新节点要建几层索引。Redis 用 25% 的概率往上加一层,所以大部分节点只在底层,少部分节点会出现在高层索引中。
删除就是先找到节点,然后把这个节点在各层的前后指针都接上,跟普通链表删除一样,只是要在多层都操作一遍。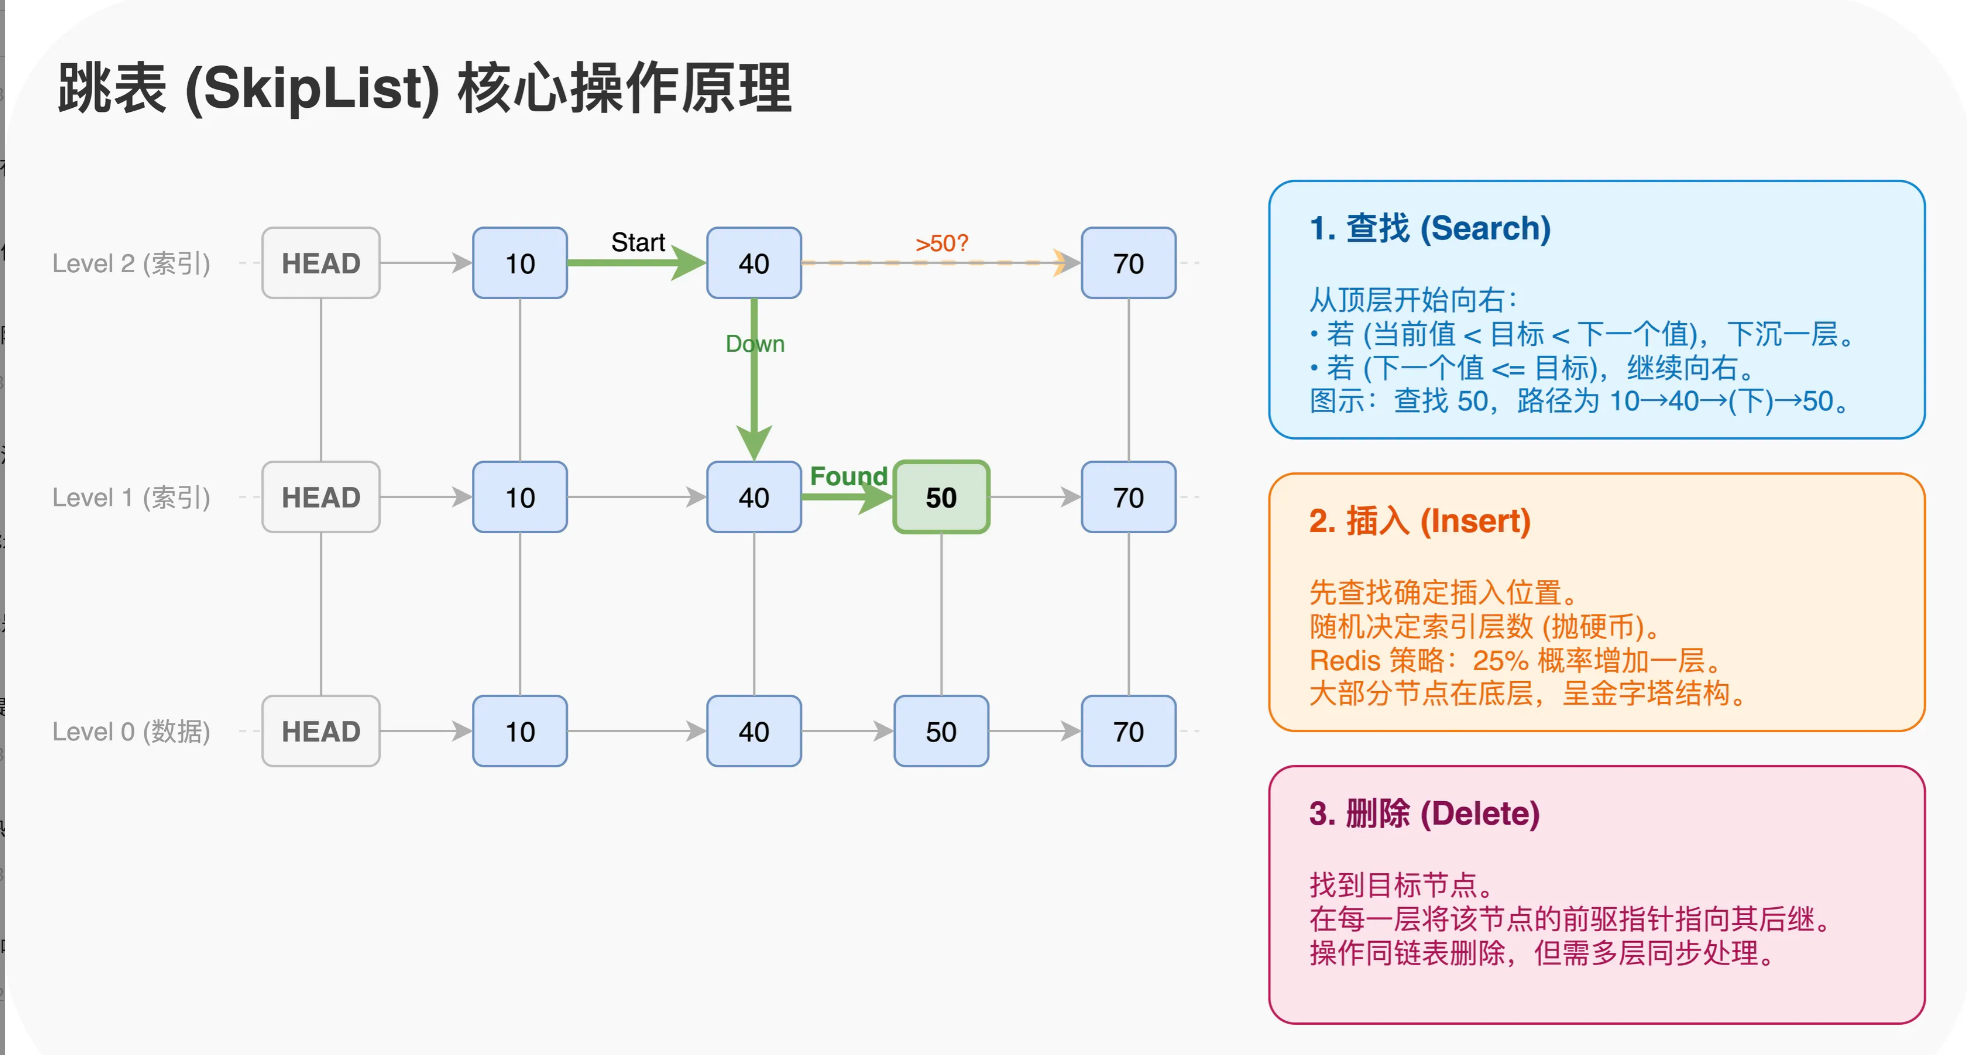 ### 为什么用跳表不用红黑树
Redis 选跳表有几个原因:
1)实现简单,红黑树那套左旋右旋太复杂,跳表就是多层链表,好写好调试
2)范围查询效率高,Zset 经常要取排名 10-20 的数据,跳表在底层链表上顺着走就行,红黑树得中序遍历
3)并发友好,跳表只需要锁住相关的几个节点,红黑树旋转的时候可能要锁一大片(这里可以提一嘴不过 Redis 执行命令是单线程的,所以并发不是主要考虑的点。说出并发友好这点的目的,是让你在面试中表现出你不仅知道数据结构差异、并发锁和性能的关系还有 Redis 的执行模型)
4)内存占用可控,跳表每个节点平均 1.33 个指针,红黑树每个节点固定 3 个指针
提问:跳表的空间复杂度是多少?比普通链表多占多少内存?
回答:跳表空间复杂度是 O(n)。因为每个节点有 25% 概率升一层,所以平均每个节点的层数是 1/(1-0.25) = 1.33 层。总指针数大约是 n * 1.33,比普通链表多 33% 左右的指针开销。
提问:跳表最高层数为什么是 32 层?能不能设成更大?
回答:32 层是够用的。每层节点数是上一层的 4 倍,32 层理论上能索引 4^32 也就是 2^64 个元素,远超实际需要。层数太多反而浪费内存,每多一层就多一个指针。Redis 5.0 之前是 64 层,后来改成 32 就是因为实际场景用不到那么多。
提问:跳表的层级概率为什么是 25% 而不是 50%?
回答:这是空间和时间的权衡。50% 的话每两个节点就有一个上升,索引层太密集,浪费内存。25% 的话平均每 4 个节点有一个上升,既能保证 O(logn) 的查询效率,又不会占太多额外空间。Redis 这个 0.25 是经过实测调优的。
提问:跳表插入和删除会不会导致索引层不平衡?
回答:不会,因为层级是随机决定的。只要随机函数够均匀,插入删除多少次,整体的层级分布都会趋近于理论值。这跟红黑树不一样,红黑树必须靠旋转维护平衡,跳表靠概率天然就是平衡的。