Redis集群的实现原理是什么?
为什么需要集群?
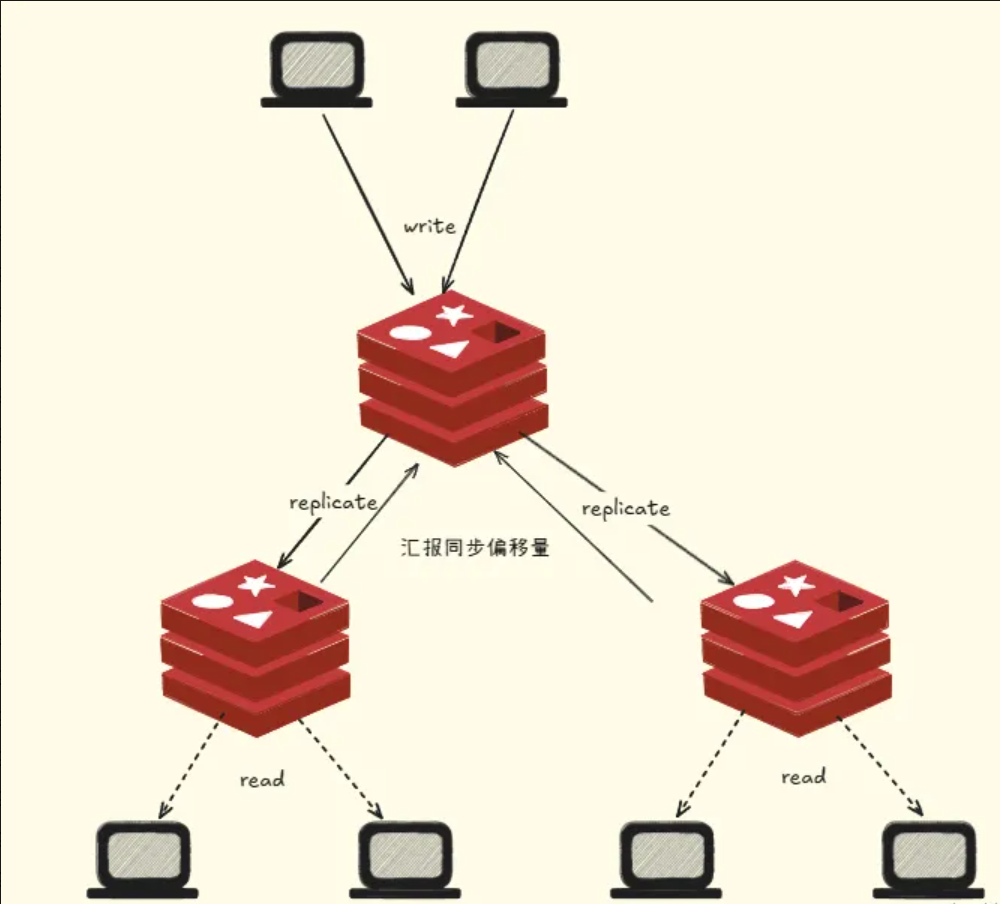
在讲Redis集群架构之前,我们先简单讲下Redis单实例的架构,从最开始的一主N从,到读写分离,再到Sentinel哨兵机制,单实例的Redis缓存足以应对大多数的使用场景,也能实现主从故障迁移。
-
单实例 Redis 缓存在某些场景下存在问题:
-
写并发:单实例读写分离能解决读操作负载均衡,但写操作全在 master 节点,海量数据高并发时,该节点易出现写瓶颈,压力上升。
-
海量数据的存储压力:单实例仅靠一台 Master 存储,面对海量数据难以应付,数据量大导致持久化成本高,可能阻塞服务器,降低服务请求成功率与服务稳定性。
-
Redis 集群提供完善方案,解决了存储受单机限制和写操作无法负载均衡的问题。
什么是集群?
-
Redis 3.0 加入集群模式,带来以下特性:
-
实现数据分布式存储:对数据分片,将不同数据存于不同 master 节点,解决海量数据存储问题。
-
去中心化思想:无中心节点,客户端视整个集群为一个整体,可连接任意节点操作,如同操作单一 Redis 实例,无需代理中间件。若操作的 key 未分配到该节点,Redis 返回转向指令,指向正确节点。
-
内置高可用机制:支持 N 个 master 节点,每个 master 节点可挂载多个 slave 节点。当 master 节点挂掉,集群会提升某个 slave 节点为新的 master 节点。
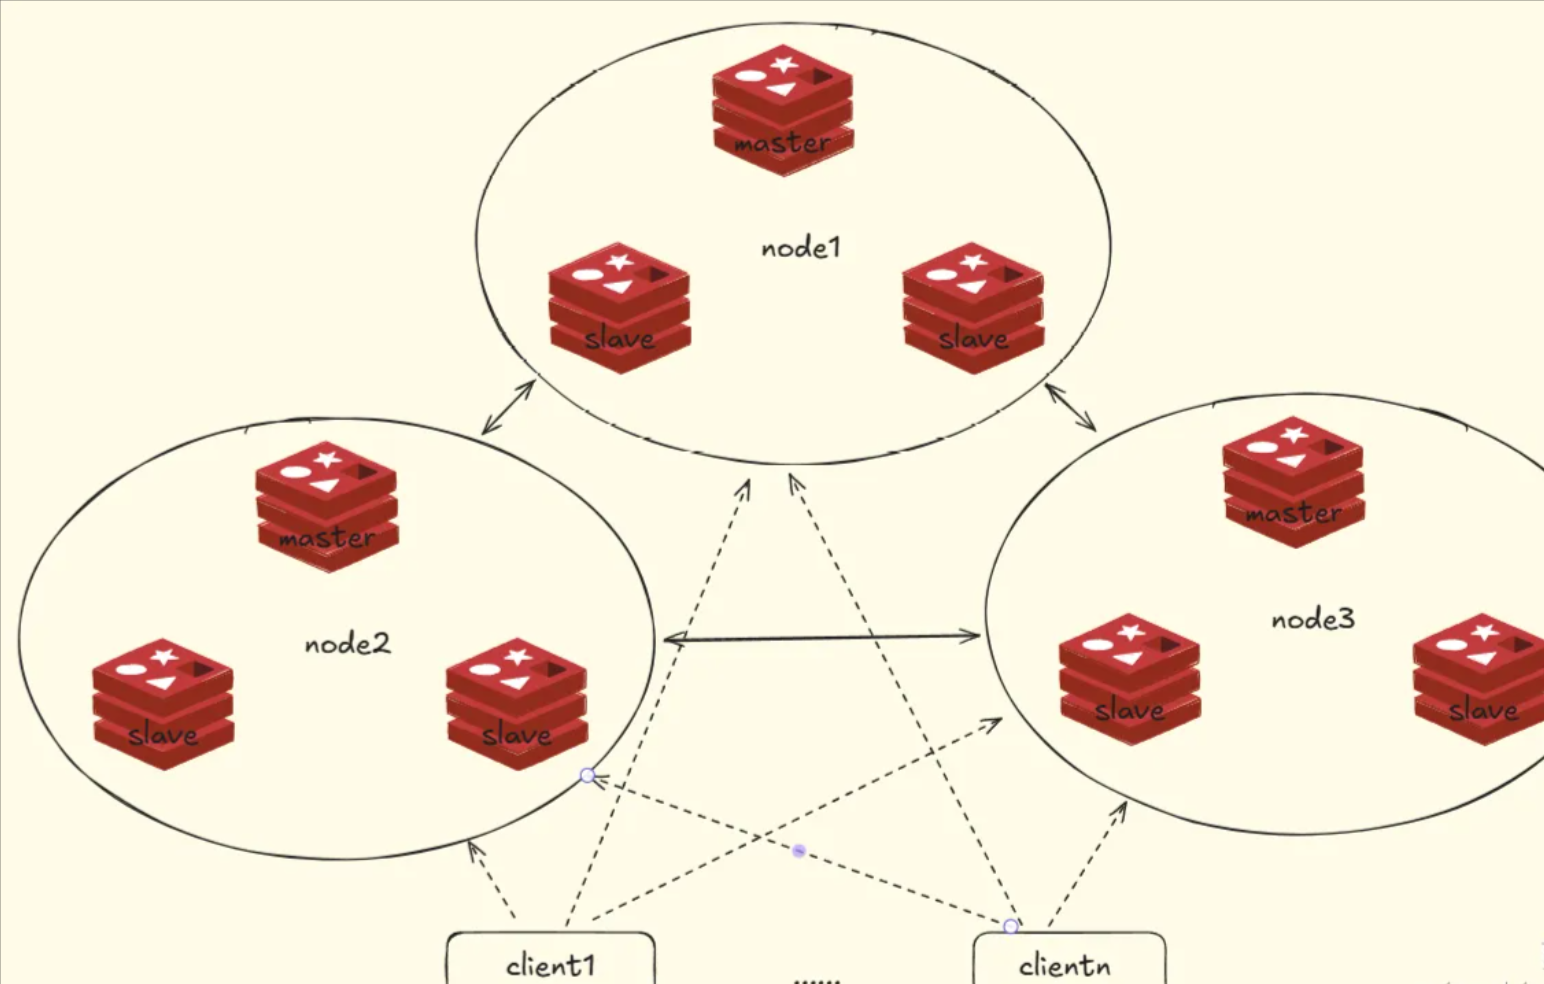
如上图所示,Redis集群可以看成多个主从架构组合起来的,每一个主从架构可以看成一个节点(其中,只有master节点具有处理请求的能力,slave节点主要是用于节点的高可用)
哈希槽算法
什么是哈希槽算法?
分布式存储需考虑如何将数据拆分到不同 Redis 服务器,常见分区算法有 hash 算法、一致性 hash 算法。
-
普通 hash 算法:
-
计算方式:将 key 用 hash 算法计算后按节点数量取余,即 hash (key)% N。
-
优点:简单。
-
缺点:扩容或摘除节点时需重新计算映射关系,导致数据重新迁移。
-
一致性 hash 算法:
-
计算方式:为每个节点分配一个 token 构成哈希环,查找时先算 key 的 hash 值,再顺时针找第一个大于等于该哈希值的 token 节点。
-
优点:加入和删除节点仅影响相邻两个节点。
-
缺点:加减节点会造成部分数据无法命中,一般用于缓存,且适用于节点量大的情况,扩容通常增加一倍节点以保障数据负载均衡 。
Redis 集群采用哈希槽分区算法:
- 集群中有 16384 个哈希槽(范围 0 - 16383),不同哈希槽分布在不同 Redis 节点管理,每个节点负责部分哈希槽。
- 数据操作时,集群用 CRC16 算法对 key 计算并对 16384 取模(slot = CRC16 (key)%16383 ),得到的值就是 Key - Value 要放入的槽。
- 通过该值找到对应槽的 Redis 节点,进而在该节点进行存取操作。
使用哈希槽的好处就在于可以方便的添加或者移除节点,并且无论是添加删除或者修改某一个节点,都不会造成集群不可用的状态。当需要增加节点时,只需要把其他节点的某些哈希槽挪到新节点就可以了;当需要移除节点时,只需要把移除节点上的哈希槽挪到其他节点就行了;哈希槽数据分区算法具有以下几种特点:
- 解耦数据和节点之间的关系,简化了扩容和收缩难度;
- 节点自身维护槽的映射关系,不需要客户端代理服务维护槽分区元数据
- 支持节点、槽、键之间的映射查询,用于数据路由,在线伸缩等场景
槽的迁移与指派命令:CLUSTER ADDSLOTS 0 1 2 3 4 … 5000
Redis中哈希槽相关的数据结构
- clusterNode数据结构:保存节点的当前状态,比如节点的创建时间,节点的名字,节点当前的配置纪元,节点的IP和地址,等等。
// 定义一个名为 clusterNode 的结构体,用于表示 Redis 集群中的节点 typedef struct clusterNode {
// 节点对象的创建时间,以毫秒为单位的时间戳 mstime_t ctime; /* Node object creation time. /
// 节点名称,是一个十六进制字符串,长度为 REDIS_CLUSTER_NAMELEN(通常为 40 字节,SHA1 哈希值的长度) char name[REDIS_CLUSTER_NAMELEN]; / Node name, hex string, sha1-size /
// 节点的标志位,用于表示节点的各种状态,如是否是主节点、从节点、是否下线等,取值为 REDIS_NODE_… 系列的常量 int flags; / REDIS_NODE_… /
// 该节点观察到的最后一个配置纪元,用于集群配置的版本管理 uint64_t configEpoch; / Last configEpoch observed for this node /
// 一个数组,用于表示该节点负责的哈希槽。每个字节表示 8 个哈希槽,REDIS_CLUSTER_SLOTS 通常为 16384,所以数组大小为 16384 / 8 unsigned char slots[REDIS_CLUSTER_SLOTS/8]; / slots handled by this node /
// 该节点负责的哈希槽数量 int numslots; / Number of slots handled by this node / // 如果该节点是主节点,这个字段表示它拥有的从节点数量 int numslaves; / Number of slave nodes, if this is a master /
// 一个指针数组,指向该主节点的所有从节点 struct clusterNode **slaves; / pointers to slave nodes /
// 指向该从节点的主节点,如果该节点本身是主节点,则为 NULL struct clusterNode *slaveof; / pointer to the master node /
// 最近一次发送 PING 命令的时间,以毫秒为单位的时间戳 mstime_t ping_sent; / Unix time we sent latest ping /
// 最近一次接收到 PONG 响应的时间,以毫秒为单位的时间戳 mstime_t pong_received; / Unix time we received the pong /
// 当该节点被标记为 FAIL 状态的时间,以毫秒为单位的时间戳 mstime_t fail_time; / Unix time when FAIL flag was set /
// 最近一次为该主节点的某个从节点投票的时间,以毫秒为单位的时间戳 mstime_t voted_time; / Last time we voted for a slave of this master /
// 最近一次接收到该节点的复制偏移量的时间,以毫秒为单位的时间戳 mstime_t repl_offset_time; / Unix time we received offset for this node /
// 该节点最近已知的复制偏移量,用于主从复制的同步 PORT_LONGLONG repl_offset; / Last known repl offset for this node. /
// 该节点最近已知的 IP 地址,长度为 REDIS_IP_STR_LEN char ip[REDIS_IP_STR_LEN]; / Latest known IP address of this node /
// 该节点最近已知的端口号 int port; / Latest known port of this node */
// 指向与该节点的 TCP/IP 连接的结构体 clusterLink *link; /* TCP/IP link with this node */
// 一个链表,存储了所有报告该节点为失败的节点信息 list *fail_reports; /* List of nodes signaling this as failing */ } clusterNode;
- clusterState数据结构:记录当前节点所认为的集群目前所处的状态。
// 定义一个名为 clusterState 的结构体,用于表示 Redis 集群的整体状态 typedef struct clusterState {
`// 指向代表本节点的 clusterNode 结构体指针     clusterNode *myself;  /* This node */`
`// 当前的集群配置纪元,用于标识集群配置的版本     uint64_t currentEpoch;`
`// 集群的当前状态,取值为 REDIS_CLUSTER_OK(集群正常)、REDIS_CLUSTER_FAIL(集群故障)等相关常量     int state;            /* REDIS_CLUSTER_OK, REDIS_CLUSTER_FAIL,... */`
`// 至少负责一个哈希槽的主节点数量     int size;             /* Num of master nodes with at least one slot */`
`// 一个字典,用于通过节点名称(字符串)查找对应的 clusterNode 结构体,方便快速定位节点     dict *nodes;          /* Hash table of name -> clusterNode structures */`
`// 一个字典,存储了在一段时间内不重新添加的节点,这些节点可能是出现问题或正在被处理的节点     dict *nodes_black_list; /* Nodes we don't re-add for a few seconds. */`
`// 一个数组,长度为 REDIS_CLUSTER_SLOTS(16384),每个元素指向一个 clusterNode 结构体,表示正在将某个哈希槽迁移到的目标节点     clusterNode *migrating_slots_to[REDIS_CLUSTER_SLOTS];`
`// 一个数组,长度为 REDIS_CLUSTER_SLOTS(16384),每个元素指向一个 clusterNode 结构体,表示正在从某个节点导入哈希槽     clusterNode *importing_slots_from[REDIS_CLUSTER_SLOTS];`
`// 一个数组,长度为 REDIS_CLUSTER_SLOTS(16384),每个元素指向一个 clusterNode 结构体,保存所有哈希槽位的分配情况     clusterNode *slots[REDIS_CLUSTER_SLOTS];//保存所有槽位分配情况`
`// 一个跳跃表,用于存储哈希槽到键的映射关系,方便根据哈希槽查找相关的键     zskiplist *slots_to_keys;          /* 以下字段用于从节点在选举中的状态 */     // 上次或下次选举的时间,以毫秒为单位的时间戳     mstime_t failover_auth_time; /* Time of previous or next election. */          // 到目前为止收到的投票数     int failover_auth_count;    /* Number of votes received so far. */          // 表示是否已经请求过投票,为真则表示已经请求过     int failover_auth_sent;     /* True if we already asked for votes. */`
`// 当前从节点在本次选举请求中的排名     int failover_auth_rank;     /* This slave rank for current auth request. */`
`// 当前选举的纪元     uint64_t failover_auth_epoch; /* Epoch of the current election. */          // 表示从节点当前不能进行故障转移的原因,取值为 CANT_FAILOVER_* 系列的宏定义     int cant_failover_reason;   /* Why a slave is currently not able to                                    failover. See the CANT_FAILOVER_* macros. */`
`/* 手动故障转移的通用状态 */`
`// 手动故障转移的时间限制(以毫秒为单位的 Unix 时间戳),如果没有正在进行的手动故障转移,则为零     mstime_t mf_end;            /* Manual failover time limit (ms unixtime).                                    It is zero if there is no MF in progress. */`
`/* 主节点手动故障转移的状态 */     /`
`/ 执行手动故障转移的从节点指针     clusterNode *mf_slave;      /* Slave performing the manual failover. */`
`/* 从节点手动故障转移的状态 */`
`// 从节点开始手动故障转移所需的主节点偏移量,如果尚未收到则为零     PORT_LONGLONG mf_master_offset; /* Master offset the slave needs to start MF                                    or zero if stil not received. */`
`// 如果非零,表示手动故障转移可以开始请求主节点投票     int mf_can_start;
`/* If non-zero signal that the manual failover                                    can start requesting masters vote. */`
`/* 以下字段用于主节点在选举中的状态 */`
`// 上次授予投票的纪元     uint64_t lastVoteEpoch;     /* Epoch of the last vote granted. */
`// 在 clusterBeforeSleep() 函数中需要完成的任务数量     int todo_before_sleep; /* Things to do in clusterBeforeSleep(). */`
`// 通过集群总线发送的消息数量     PORT_LONGLONG stats_bus_messages_sent;  /* Num of msg sent via cluster bus. */`
`// 通过集群总线接收的消息数量     PORT_LONGLONG stats_bus_messages_received; /* Num of msg rcvd via cluster bus.*/ } clusterState;
节点的槽指派信息
clusterNode数据结构的slots属性和numslot属性记录了节点负责处理那些槽:slots属性是一个二进制位数组(bit array),这个数组的长度为16384/8=2048个字节,共包含16384个二进制位。Master节点用bit来标识对于某个槽自己是否拥有,时间复杂度为O(1)
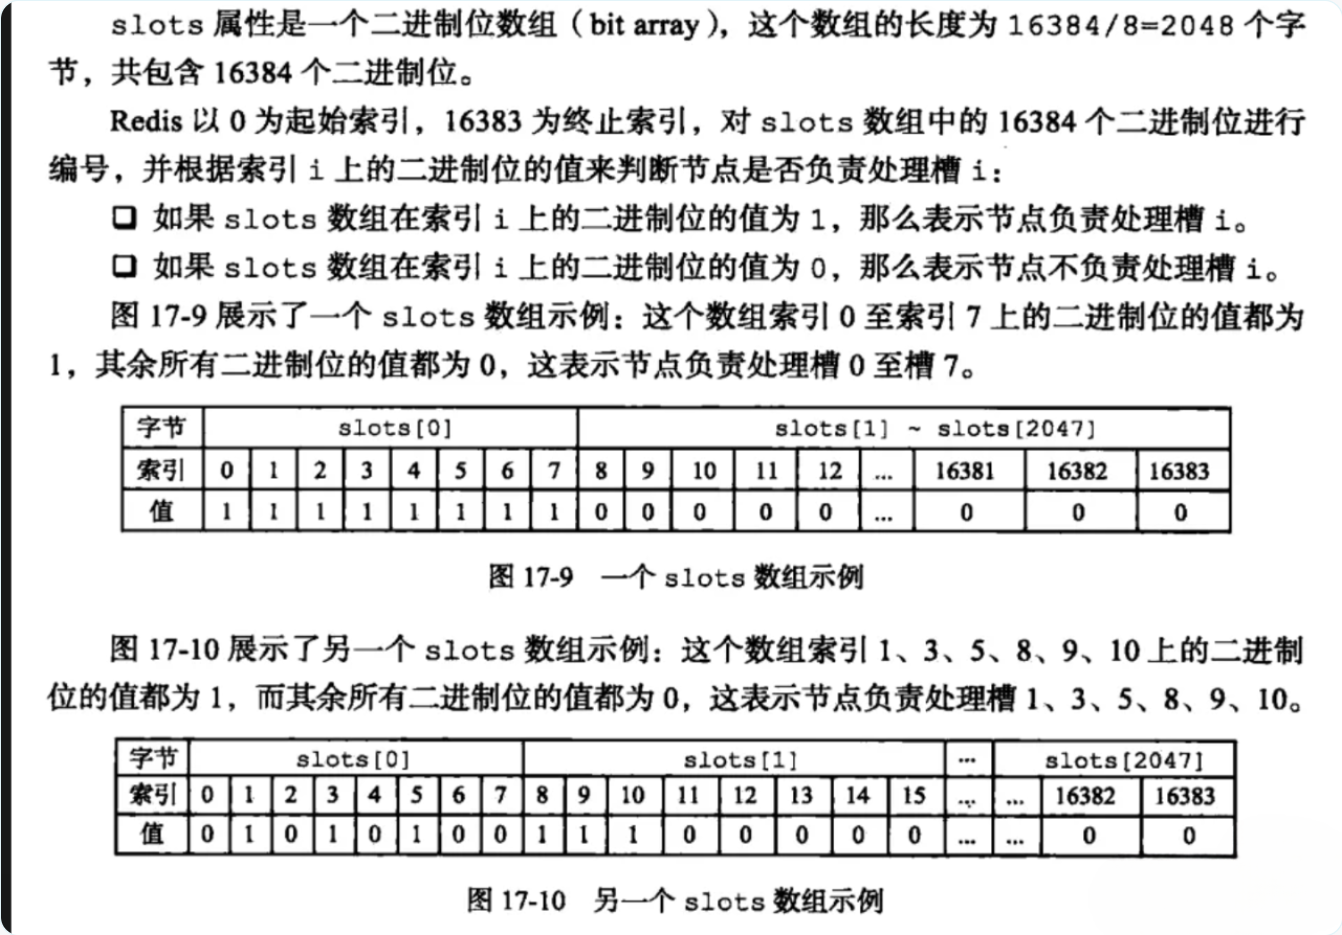
集群所有槽的指派信息
当收到集群中其他节点发送的信息时,通过将节点槽的指派信息保存在本地的clusterState.slots数组里面,程序要检查槽i是否已经被指派,又或者取得负责处理槽i的节点,只需要访问clusterState.slots[i]的值即可,时间复杂度仅为O(1)
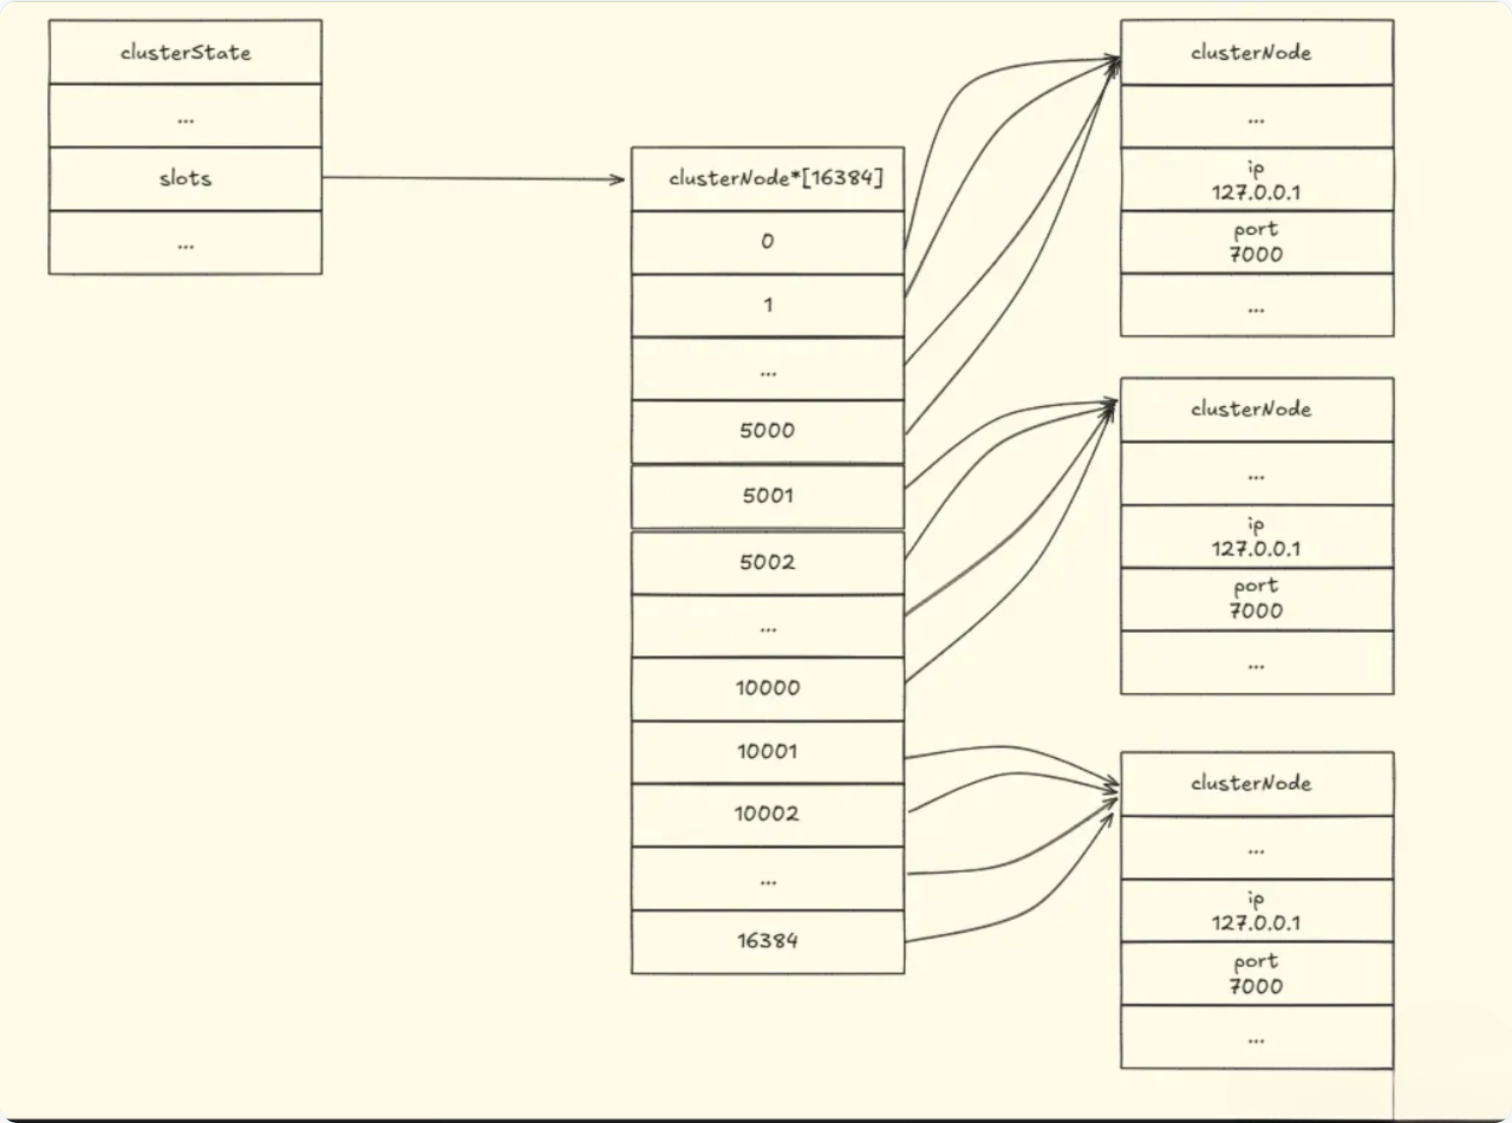
ClusterState 中的 Slots 数组下标对应槽,槽信息对应 clusterNode(缓存节点),节点含实际 Redis 缓存服务的 IP 和 Port 信息。Redis Cluster 通讯机制确保各节点有其他节点和槽数据对应关系,因每个节点都有 ClusterState 记录所有槽与节点对应关系,所以客户端访问集群中任意节点都可路由到对应节点。
集群的请求重定向
前面讲到,Redis集群在客户端层面没有采用代理,并且无论Redis 的客户端访问集群中的哪个节点都可以路由到对应的节点上,下面来看看 Redis 客户端是如何通过路由来调用缓存节点的:
- MOVED请求
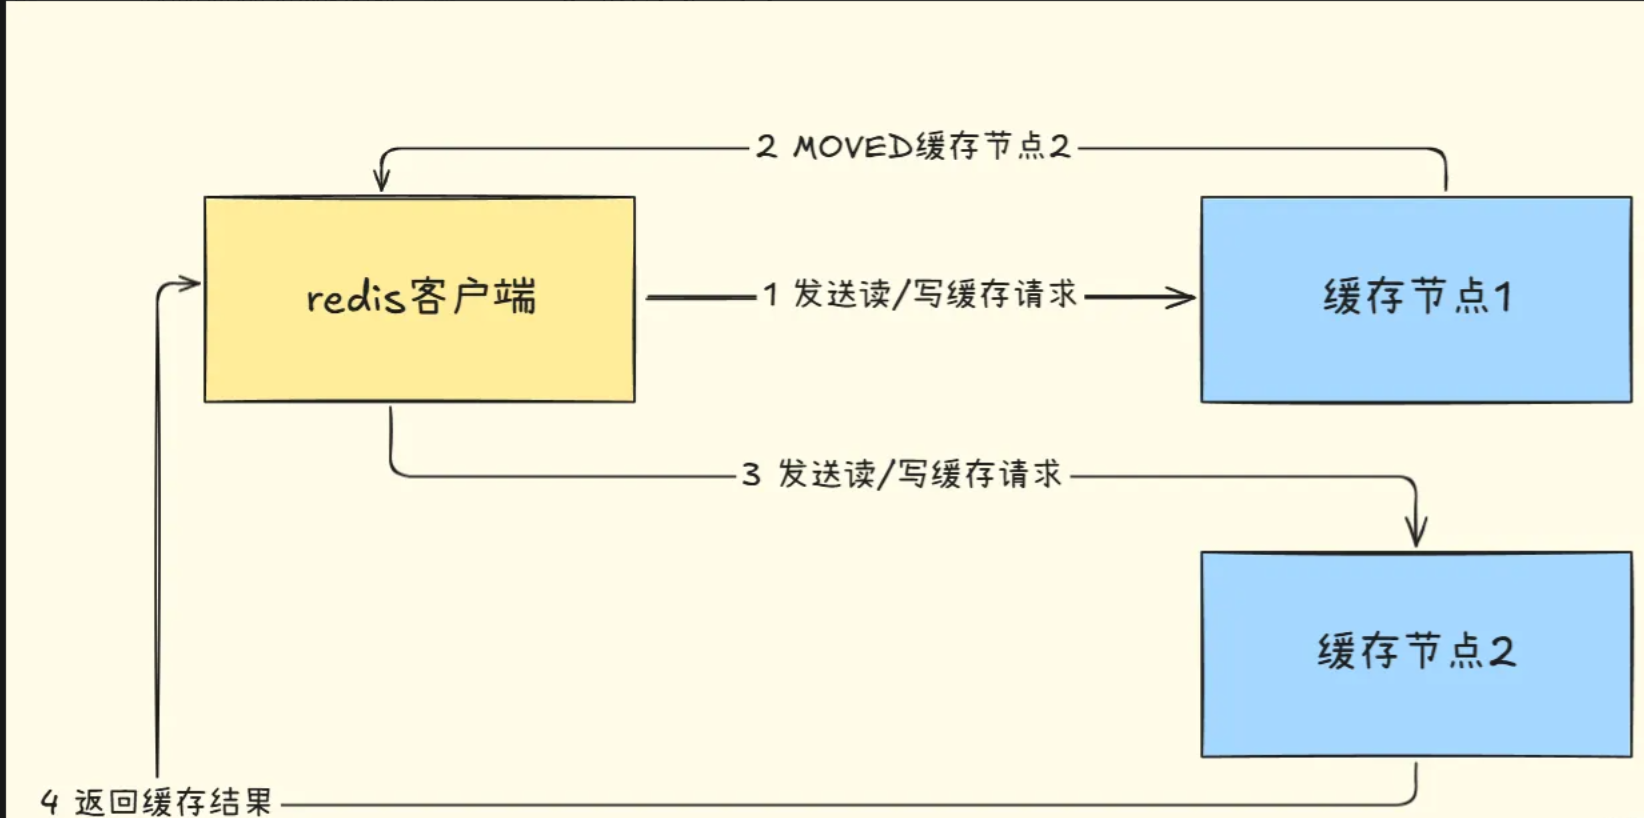
- Redis 客户端经计算找 “缓存节点 1” 操作数据。
- 因数据迁移等,对应 Slot 数据到 “缓存节点 2”,客户端无法从 “缓存节点 1” 获取。
- “缓存节点 1” 存集群节点信息,知数据在 “缓存节点 2”,发 MOVED 重定向请求。
- 客户端获 “缓存节点 2” 地址,继续访问并拿到数据。
- ASK请求
上面的例子说明了,数据 Slot 从“缓存节点1”已经迁移到“缓存节点2”了,那么客户端可以直接找“缓存节点2”要数据。那么如果两个缓存节点正在做节点的数据迁移,此时客户端请求会如何处理呢?
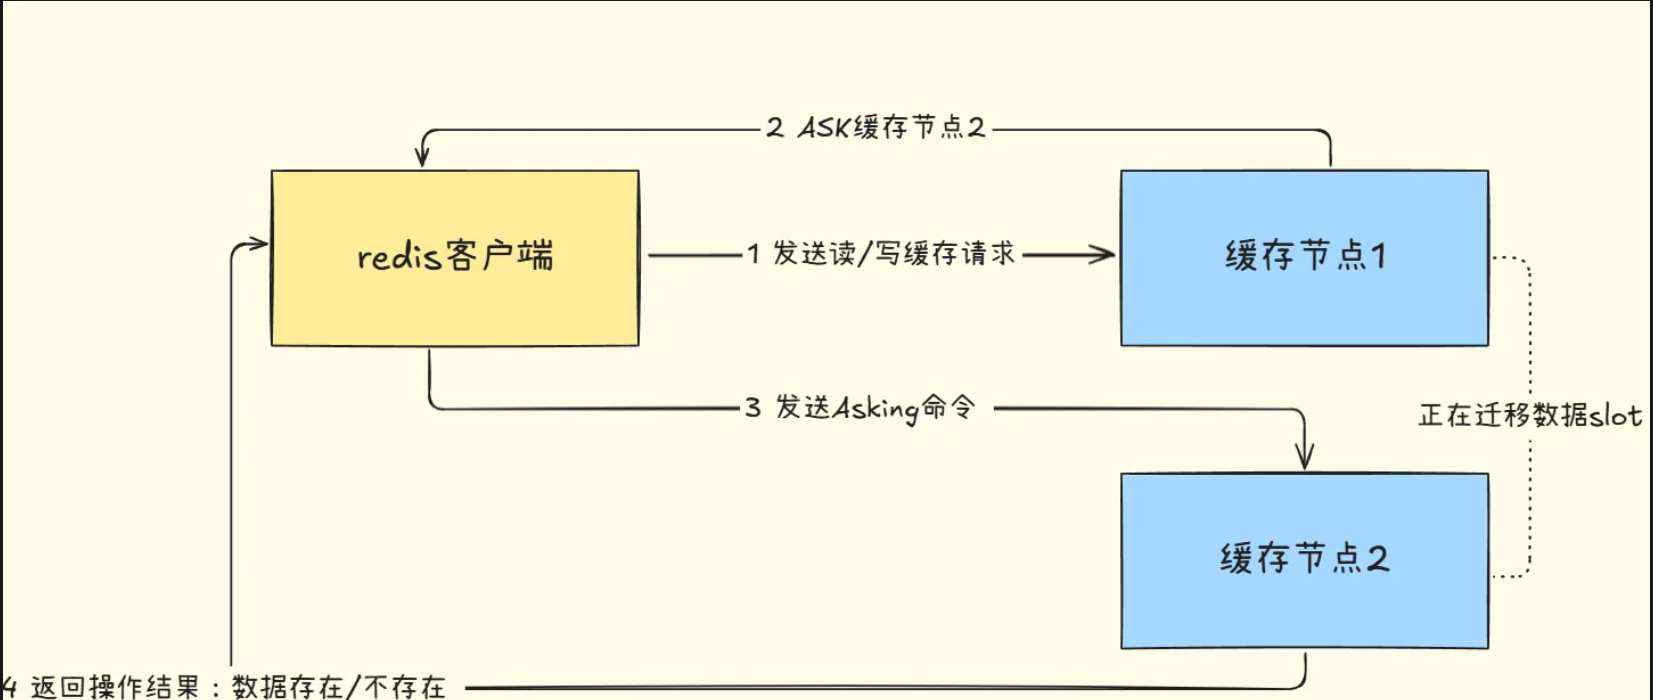
-
Redis 客户端向 “缓存节点 1” 发出请求。
-
若 “缓存节点 1” 正向 “缓存节点 2” 迁移数据且未命中对应 Slot:
-
“缓存节点 1” 会返回客户端一个 ASK 重定向请求,并告知 “缓存节点 2” 的地址。
-
客户端向 “缓存节点 2” 发送 Asking 命令,询问所需数据是否在 “缓存节点 2” 上。
-
“缓存节点 2” 接到消息后,返回数据是否存在的结果。
-
频繁重定向造成的网络开销的处理:smart客户端
-
什么是smart客户端
在大部分情况下,可能都会出现一次请求重定向才能找到正确的节点,这个重定向过程显然会增加集群的网络负担和单次请求耗时。所以大部分的客户端都是smart的。所谓 smart客户端,就是指客户端本地维护一份hashslot => node的映射表缓存,大部分情况下,直接走本地缓存就可以找到hashslot => node,不需要通过节点进行moved重定向,
- JedisCluster的工作原理
-
JedisCluster 初始化时:
-
随机选择一个 node。
-
初始化 hashslot => node 映射表。
-
为每个节点创建一个 JedisPool 连接池。
-
每次基于 JedisCluster 执行操作时:
-
先在本地计算 key 的 hashslot。
-
在本地映射表找到对应的节点 node。
-
存在两种情况:
-
若该 node 仍持有此 hashslot,则操作正常进行。
-
若进行了 reshard 操作,hashslot 不在该 node 上,会返回 moved。
-
当 JedisCluster API 发现对应节点返回 moved 时:
-
利用节点返回的元数据,更新本地的 hashslot => node 映射表缓存。
-
重复上述步骤直至找到对应节点。
-
若重试超过 5 次:
-
报错,抛出 JedisClusterMaxRedirectionException。
- hashslot迁移和ask重定向
若 hashslot 正在迁移,会向客户端返回 ask 重定向,客户端接收后重新定位到目标节点执行;因 ask 发生在迁移过程中,JedisCluster API 收到 ask 不会更新 hashslot 本地缓存。ASK 和 MOVED 虽都是对客户端的重定向控制,但有本质区别:ASK 重定向表明集群正在进行 slot 数据迁移,客户端无法知晓迁移完成时间,属于临时性重定向,客户端不更新 slots 缓存;MOVED 重定向说明键对应的槽已明确指定到新节点,客户端需更新 slots 缓存。
Redis集群中节点的通信机制:goosip协议
Redis 集群的哈希槽算法解决数据存取问题,不同哈希槽分布在不同节点,各节点维护自身认知的集群状态,且集群采用去中心化架构。当集群状态如新节点加入、slot 迁移、节点宕机、从节点提升为主节点等发生变化时,需让其他节点尽快知晓,那么 Redis 如何处理以及不同节点间怎样通信以维护集群同步状态的呢?
在Redis集群中,不同的节点之间采用gossip协议进行通信,节点之间通讯的目的是为了维护节点之间的元数据信息。这些元数据就是每个节点包含哪些数据,是否出现故障,通过gossip协议,达到最终数据的一致性。