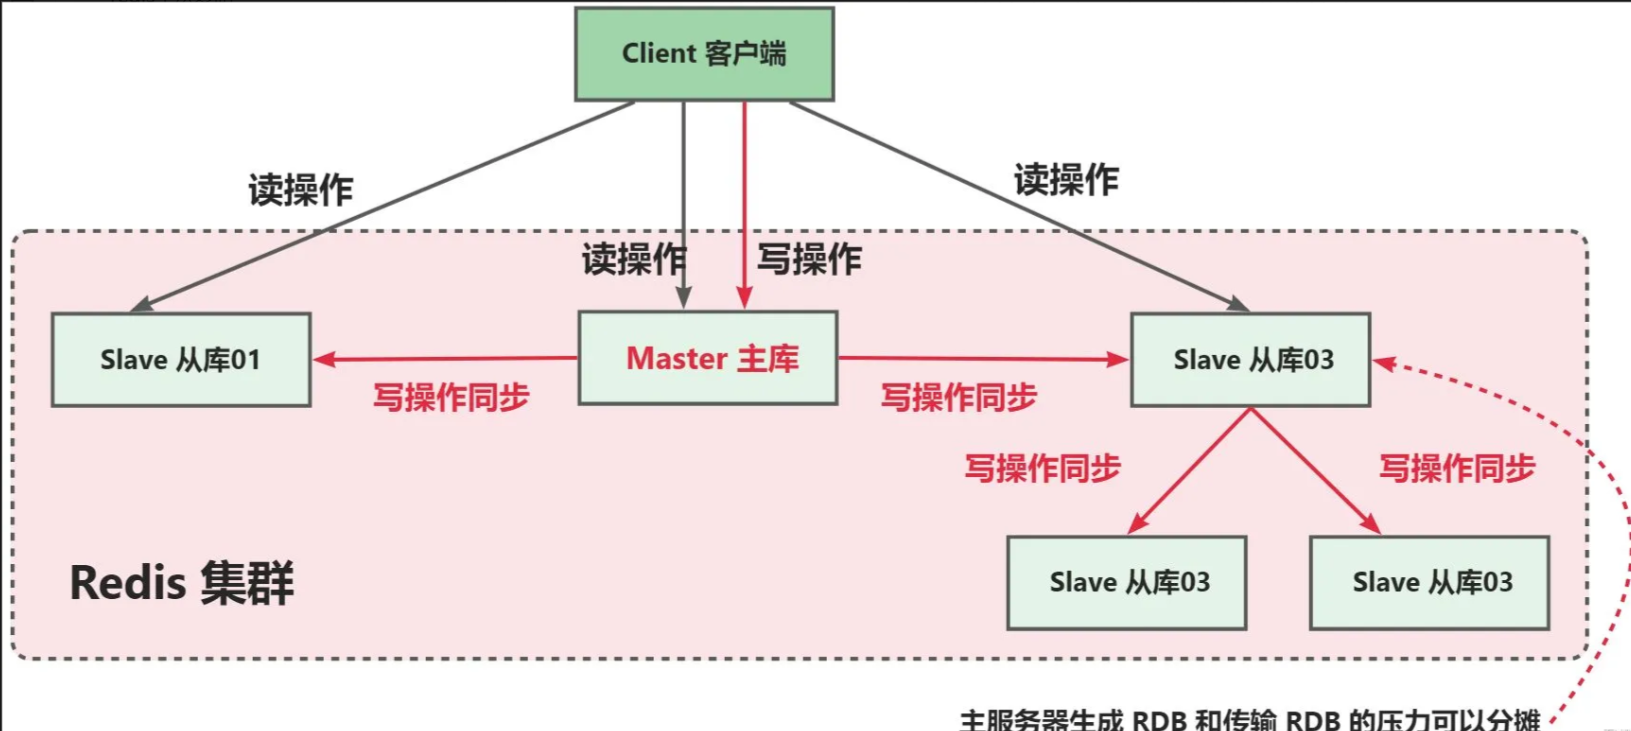
首先我先说说主从复制是什么?为了减轻redis的压力,使用了读写分离的形式,也就是主节点写,从节点读,这样就要求主从节点数据必须一致,所以就有了主从复制。主从复制就是,将一个主节点上的数据全部复制到其他的从节点上,以保持主从节点的数据一致。
具体怎么实现的呢?首先,其他节点需要先向主节点发送psync命令来发起开始同步。接着,主节点通过发送来的psync来判断是进行全局同步还是增量复制。假如是第一次进行同步,或者是之前的连接失效,就会进行全量复制。全量复制完毕后,主从节点之间会维护一个长链接,在此期间会将主节点的操作进行增量复制到从节点,维护主从节点一致性。
为什么需要主从复制?
- 降低数据冗余: 主从复制实现了数据的热备份,是持久化之外的一种数据冗余方式。
- 提供故障恢复: 当主节点出现问题时,可以由从节点提供服务,实现快速的故障恢复;
- 支持负载均衡: 主从复制配合读写分离,主节点写服务,从节点读服务,写数据连主节点,读数据连从节点,可分担服务器负载。写少读多场景下,多个从节点分担读负载,提高 Redis 服务器并发量。
- 高可用: 主从复制是 Redis 高可用的基础,也是哨兵和集群实施的基础。
主从库之间采用的是 读写分离 的方式:
- 读操作: 主库、从库可以接收
- 写操作: 仅主库可执行,然后主库将写操作同步给从库
两种同步复制方式
- 全量复制: 第一次同步时
- 增量复制: 只会把主从库网络断联期间主库收到的命令同步交给从库
全量复制
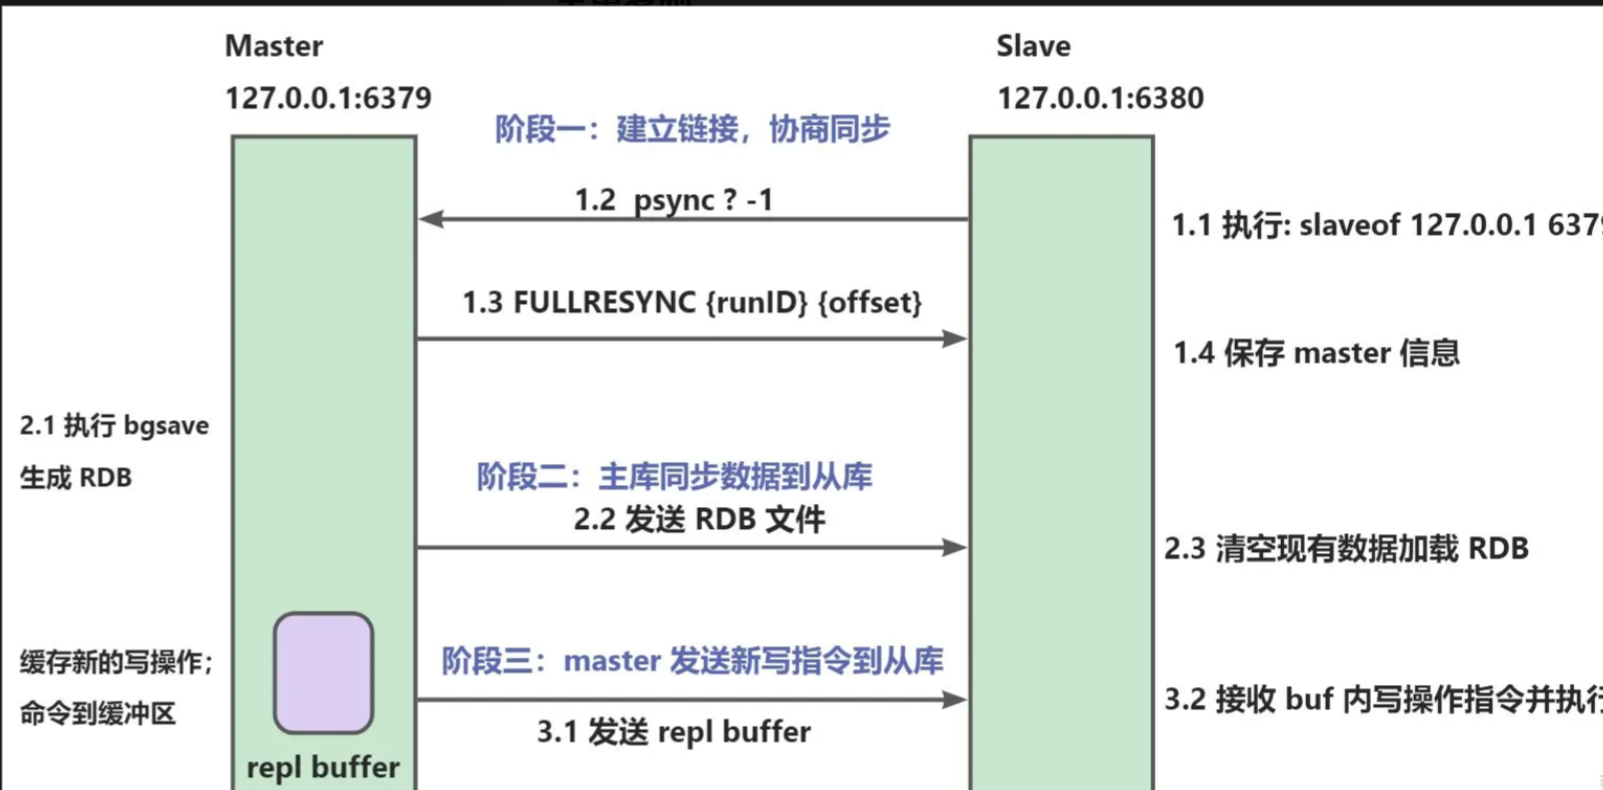
基于 TCP 长连接避免频繁建立 TCP 链接和断开带来的性能开销,分为三阶段如图:
- 假设主机 Master 在
6379端口,从机 Slave 在6380端口; 基于本机 (方便理解后续扩展内容: 搭建一主多从) - 其中
repl buffer是replication buffer简写
第一阶段
slave 向 master 发送 psync指令,表示进行数据同步,
psync包含两个参数,分别是 主服务器的 runID 和 复制进度 offset
runID: 标识每一个 Redis 服务器offset: 第一次同步表示 -1
FULLRESYNC 响应命令意图是全量复制,主服务器将所有数据同步给从服务器。
第二阶段
Master 执行 bgsave 指令来生成 RDB 文件,然后把文件发送给从服务器
Slave 接收到 Master 传输的 RDB 之后,会先清空当前的数据,然后载入 RDB 文件
Master 通过 bgsave指令会产生一个子进程来进行 RDB 文件生成的工作,是异步工作的。
这期间写操作命令未记录到刚生成的 RDB 文件中,主从服务器数据不一致。
为了保证一致性,Master 在三个时间间隙将写操作命令写入 replication buffer 缓冲区。
- Master 生成 RDB 文件期间
- Master 发送 RDB 文件给 Slave 服务器期间
- Slave 加载 RDB 文件期间
第三阶段
Master 生成的 RDB 文件发送完,Slave 收到后,丢弃旧数据,载入 RDB 数据到内存,完成载入后回复确认消息给 Master。
然后 Master 需要将这期间记载的在 replication buffer 缓冲区内的写操作记录也发送给 Slave, 保证一致性
问题:
但是第一次全量复制之后如果遇到网络问题无法进行命令传播,Slave 就无法和 Master 保持同步了,导致不一致性 而如果恢复连接之后使用全量复制保证一致性的话开销太大,因为有一部分数据已经一致。有什么办法吗?
增量复制
图示:
- repl backlog 表示
repl_backlog_buffer - repl buffer 表示
replication buffer
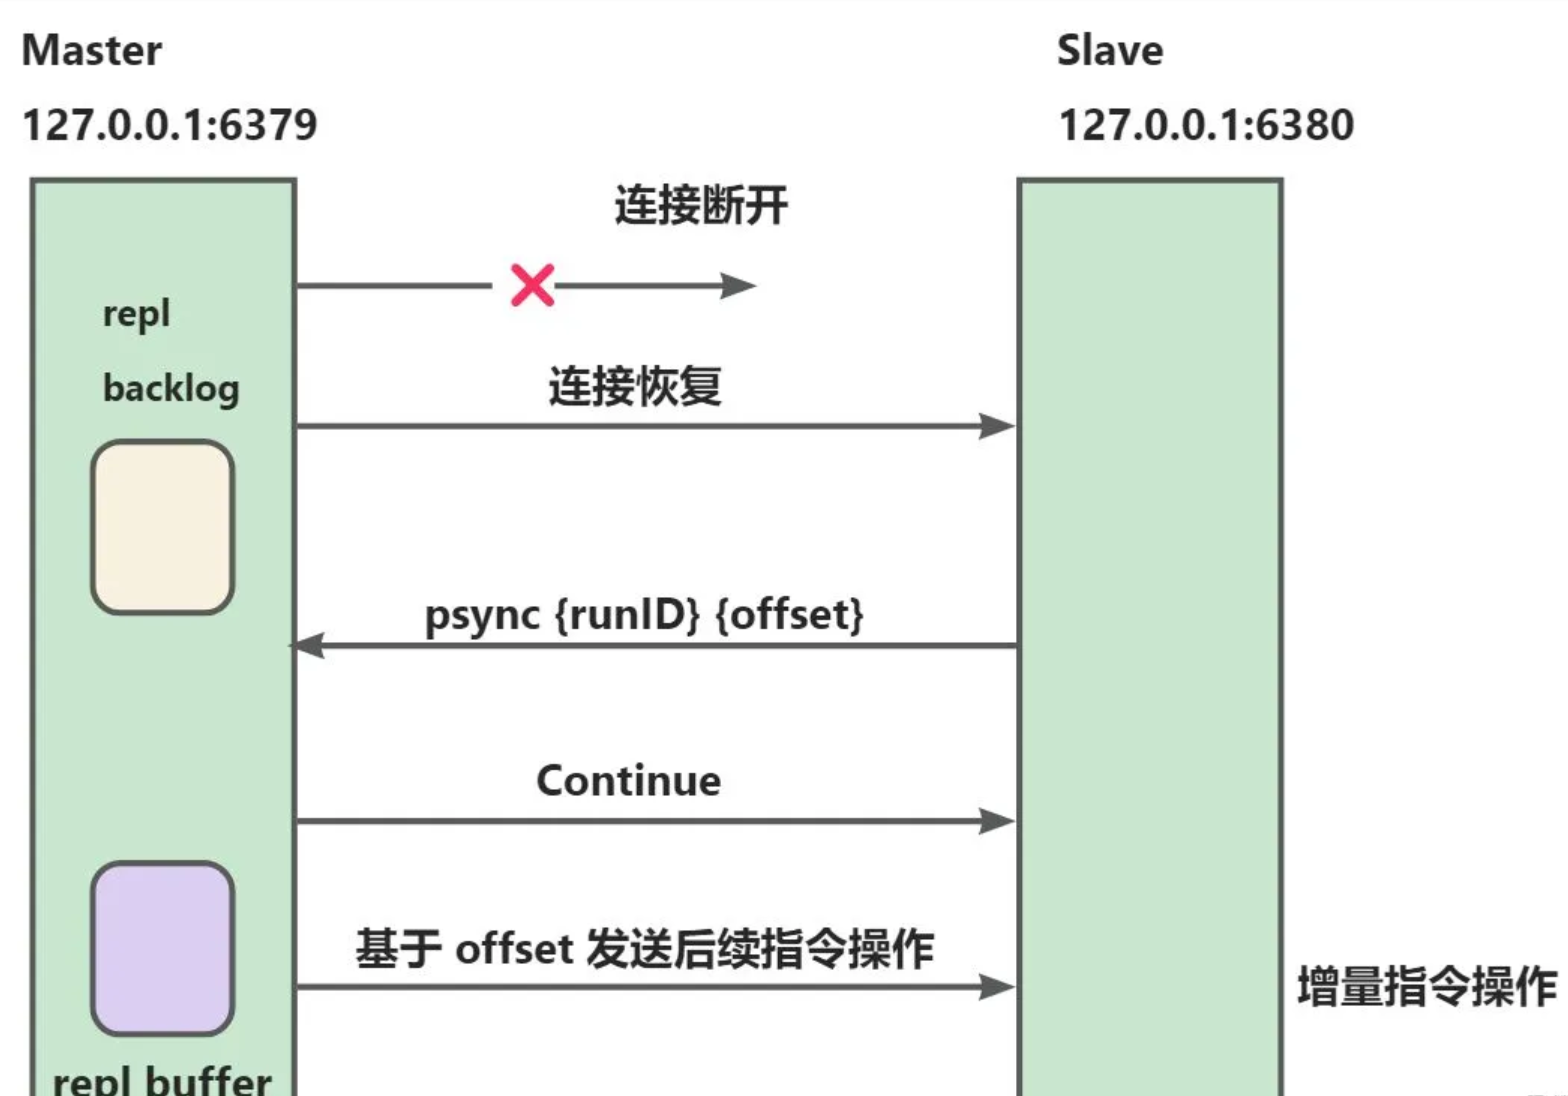
过程
- 服务器恢复网络后,会向主服务器发送
psync命令(offset 非 -1)。 - 主服务器收到后,用
CONTINUE响应命令告知从服务器采用增量复制同步数据。 - 接着,主服务器将断线期间执行的写命令发给从服务器,从服务器执行这些命令。
其中:
repl_backlog_buffer是一个 ⌈环形⌋ 缓冲区,用于主从服务器断开连接后,从中找到差异的数据replication offset标记同步进度,Master 用于记录自己写的未知,Slave 记录自己读的未知
repl_backlog_buffer 缓存的写入时机
- Master 在将写指令发送给 Slave 的同时,将其写入到
repl_backlog_buffer缓冲区内
如何辨别应该向 Slave 执行全量复制还是增量复制
Slave 通过 psync指令将自己的 slave_repl_offset 发送给主服务器;服务器依据 master_repl_offset 与 slave_repl_offset 的差距决定对从服务器的同步操作。
- 若从服务器所需数据在
repl_backlog_buffer缓冲区,主服务器采用增量同步; - 若不在,主服务器采用全量同步。
由于 repl_backlog_buffer 缓冲区的默认大小是 1M。 由于时一个环形缓冲区,如果写满,会发生 覆盖问题 。网络恢复时,若服务器想读的数据被覆盖,主服务器采用全量同步,此方式比增量同步性能损耗大很多。
因此为了避免频繁的全量同步,应该调大 repl_backlog_buffer
推荐大小
second * write_size_per_second
second为从服务器断线后重新连接上主服务器所需的平均时间 (单位 s)write_size_per_second则是主服务器平均每秒产生的写命令数据量大小。
支持基于 redis.conf 配置项修改 repl_backlog_buffer 缓冲区大小

(扩展) - 如何搭建一主多从?
创建一个测试目录
修改 redis.conf
- 确认其中的配置项为
daemonize = yes
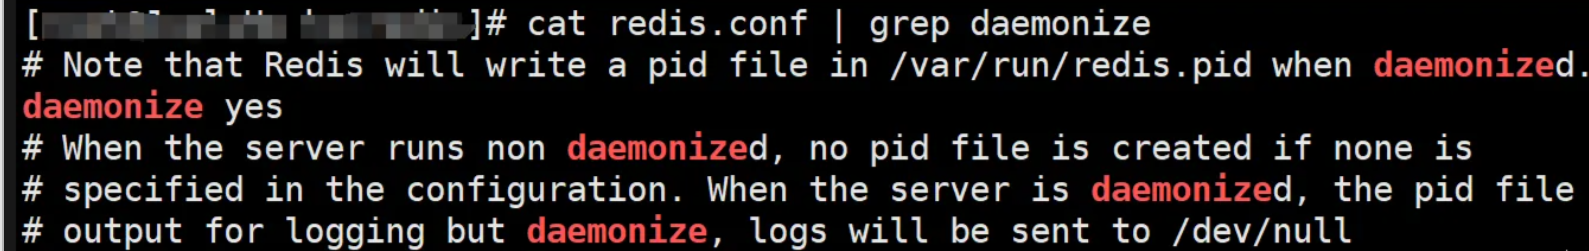
并且仅开启 RDB 备份持久化策略
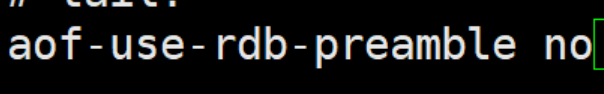
- 关闭混合持久化策略
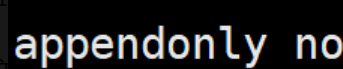
aof-user-rdb-preamble设置为no - 关闭 AOF 持久化策略
appendonly设置为no
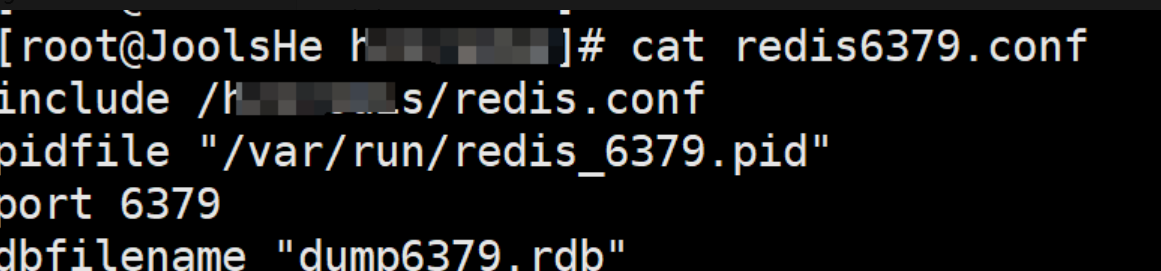
分别创建三个配置文件
示例: redis6379.conf、redis6380.conf、redis6381.conf
并且分别添加如下配置
include [放置配置文件的目录路径]/redis.conf
pidfile /var/run/redis_6379.pid
port [基于文件后缀,比如 6379 端口]
dbfilename dump[端口].rdb
参考配置
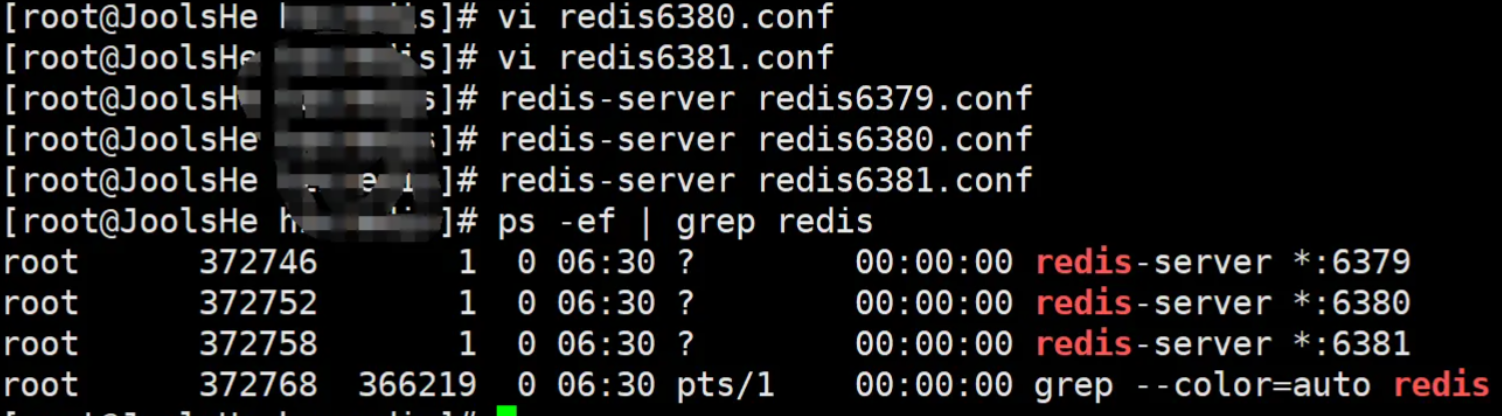
分别启动三台 redis 服务器
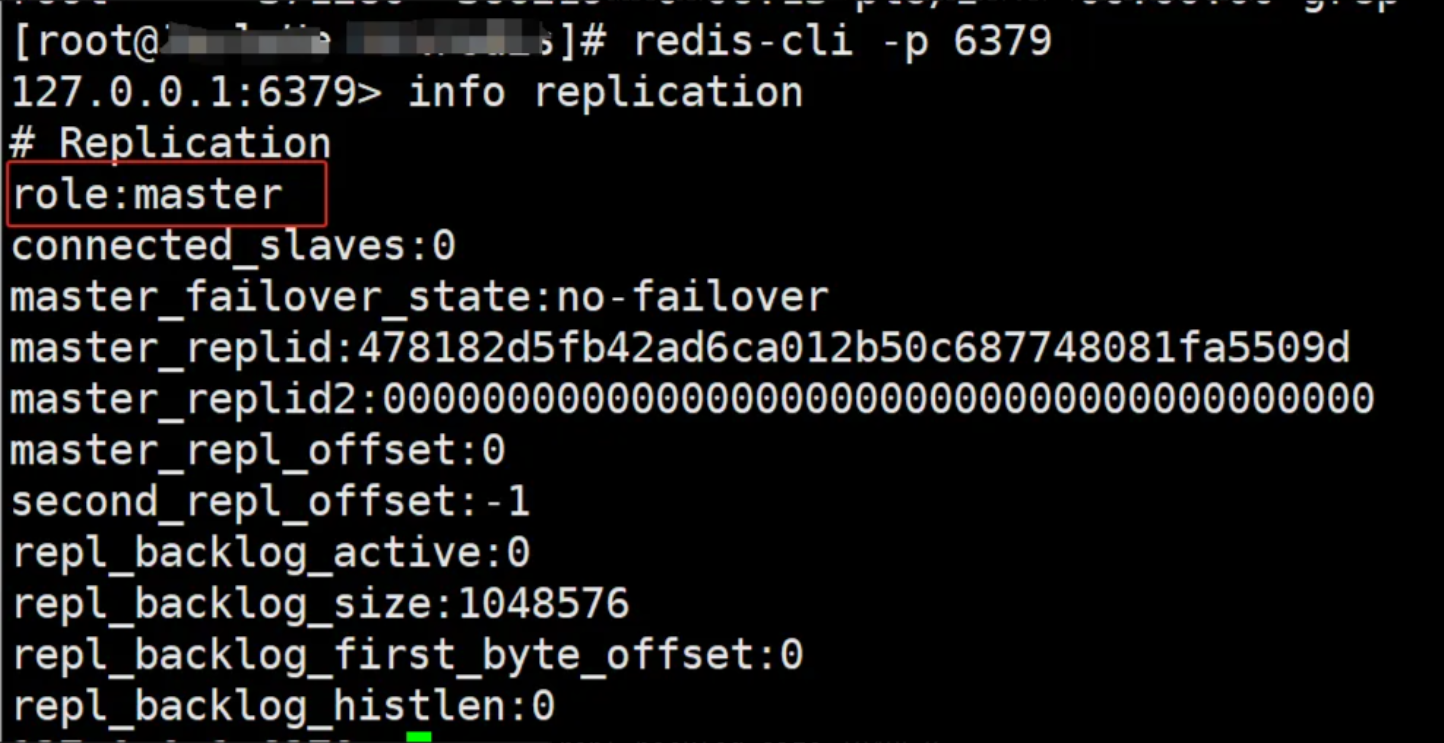
连接查看相关信息
- 指令
info replication用于打印主从复制的相关信息
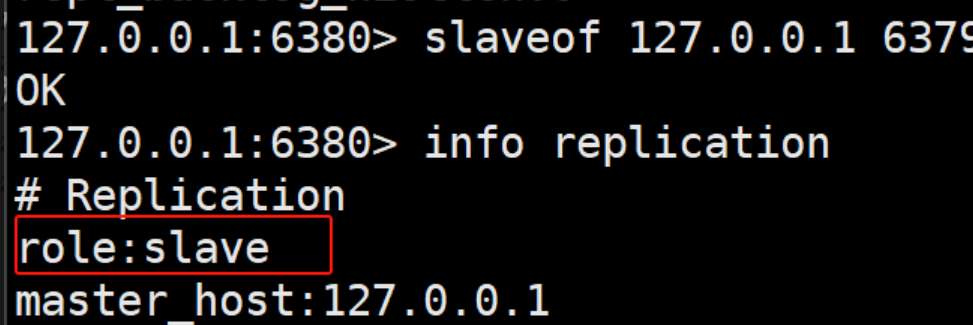
配置主从关系
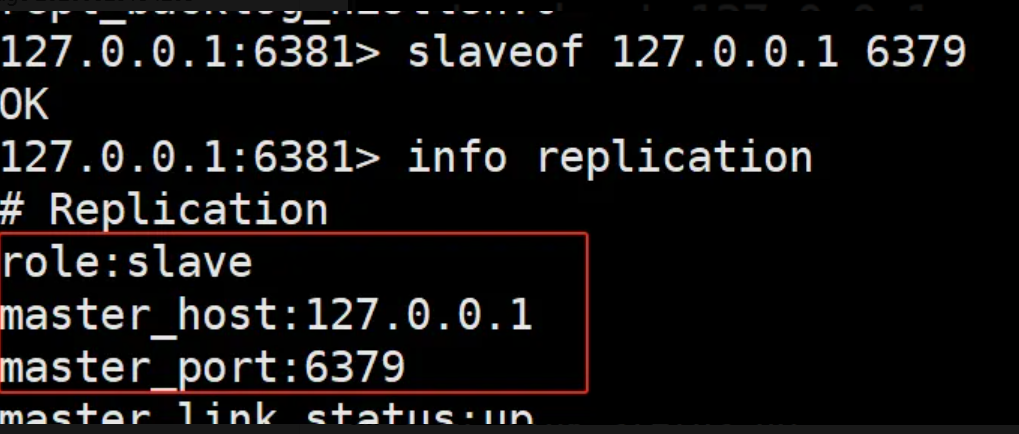
将 6380 和 6381 配置成为 Slave ; 而 6379 作为主机 Master 借助如下指令,配置某个实例的从服务器
- 指令
slaveof <master_ip> <master_port>
127.0.0.1:6380> slaveof 127.0.0.1 6379
OK
127.0.0.1:6380> info replication
# Replication
role:slave
master_host:127.0.0.1
master_port:6379
master_link_status:up
master_last_io_seconds_ago:4
master_sync_in_progress:0
slave_read_repl_offset:0
slave_repl_offset:0
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:6635dfe974961f6624785748ea2ed035bc670b99
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:0
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:0
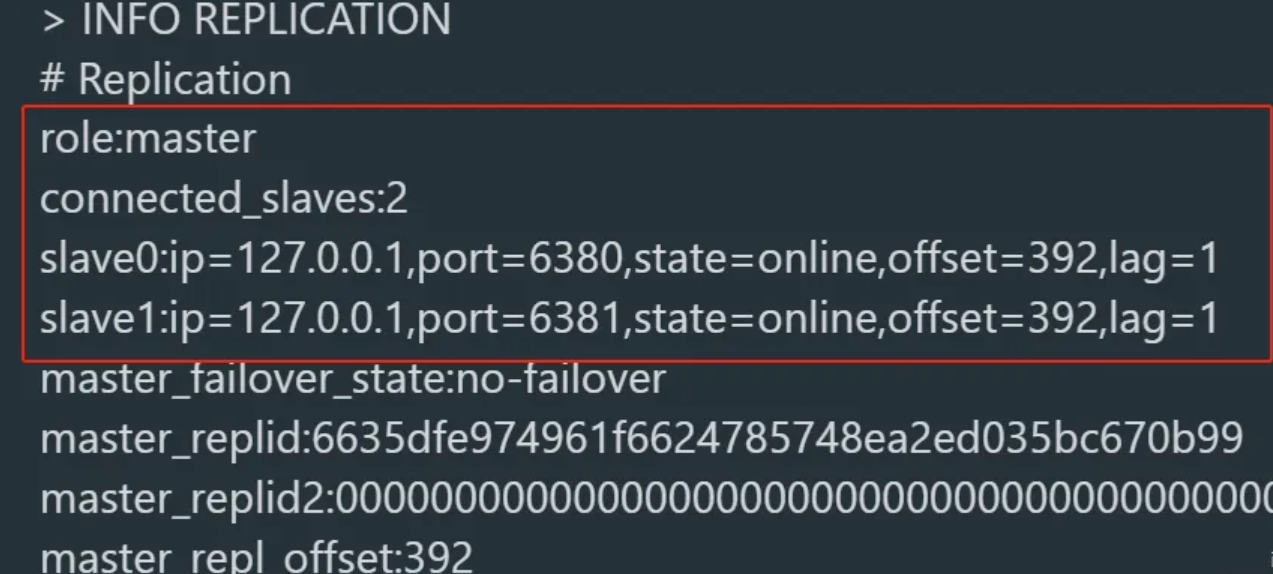
查看主机信息
配置了两个从节点
- 一个为端口
6380的服务 - 一个为端口
6381的服务
测试: 主机支持读写,但是从机仅支持读
主机 Master 支持读写 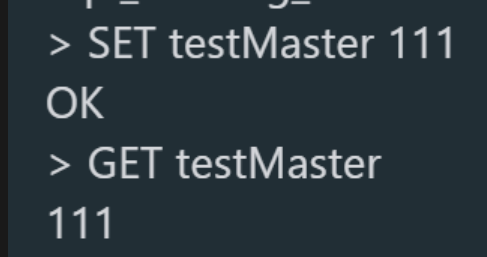
从机 Slave 仅支持读
尝试写报错: READONLY You can’t write against a read only replice.

(扩展) - 测试主从复制 之 全量复制
流程简述:
- Slave 启动成功会连接到
master后会发送一个sync指令 - Master 接到命令启动后台的存盘进程,同时收集所有接收到的用于修改数据的指令,在后台进程执行完毕之后,Master 将传送整个数据文件到 slave, 完成一次完全同步
- Slave 服务在接收到数据库文件数据之后,将其存盘并且加载到内存之中,即
全量复制
测试:Slave down 后重启仍然获取到 Master 最新数据
Master 添加数据
- 推荐这个好用的 Redis 可视化工具
Another Redis Desktop Manager(๑•̀ㅂ•́)و✧
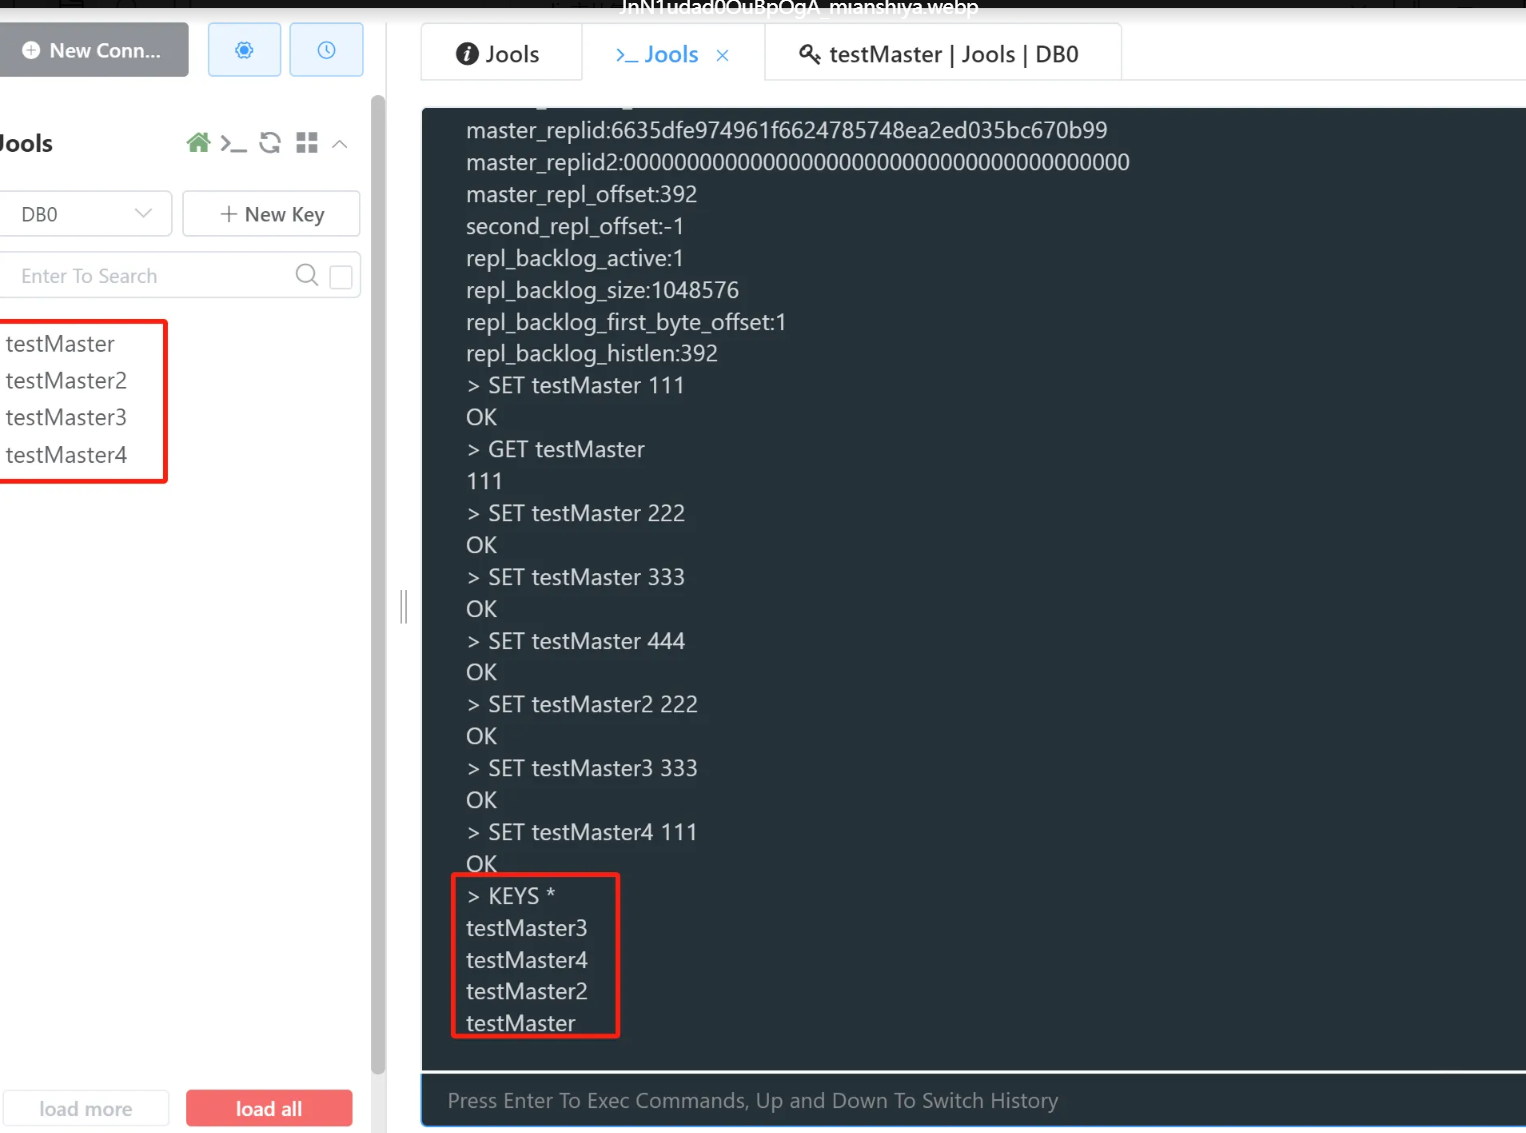
查看从库
- 已经自动同步
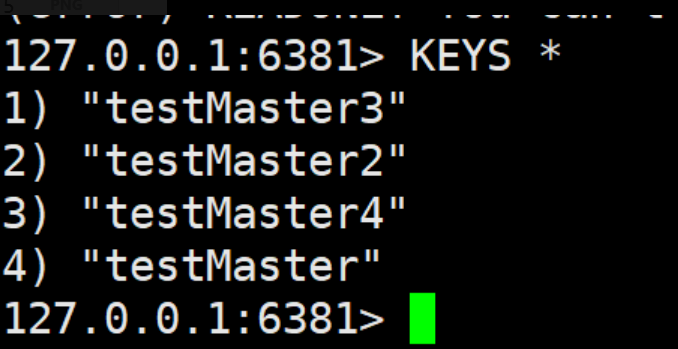
停止从库
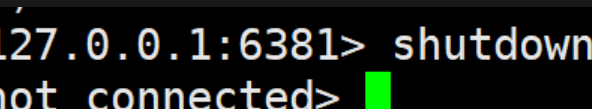
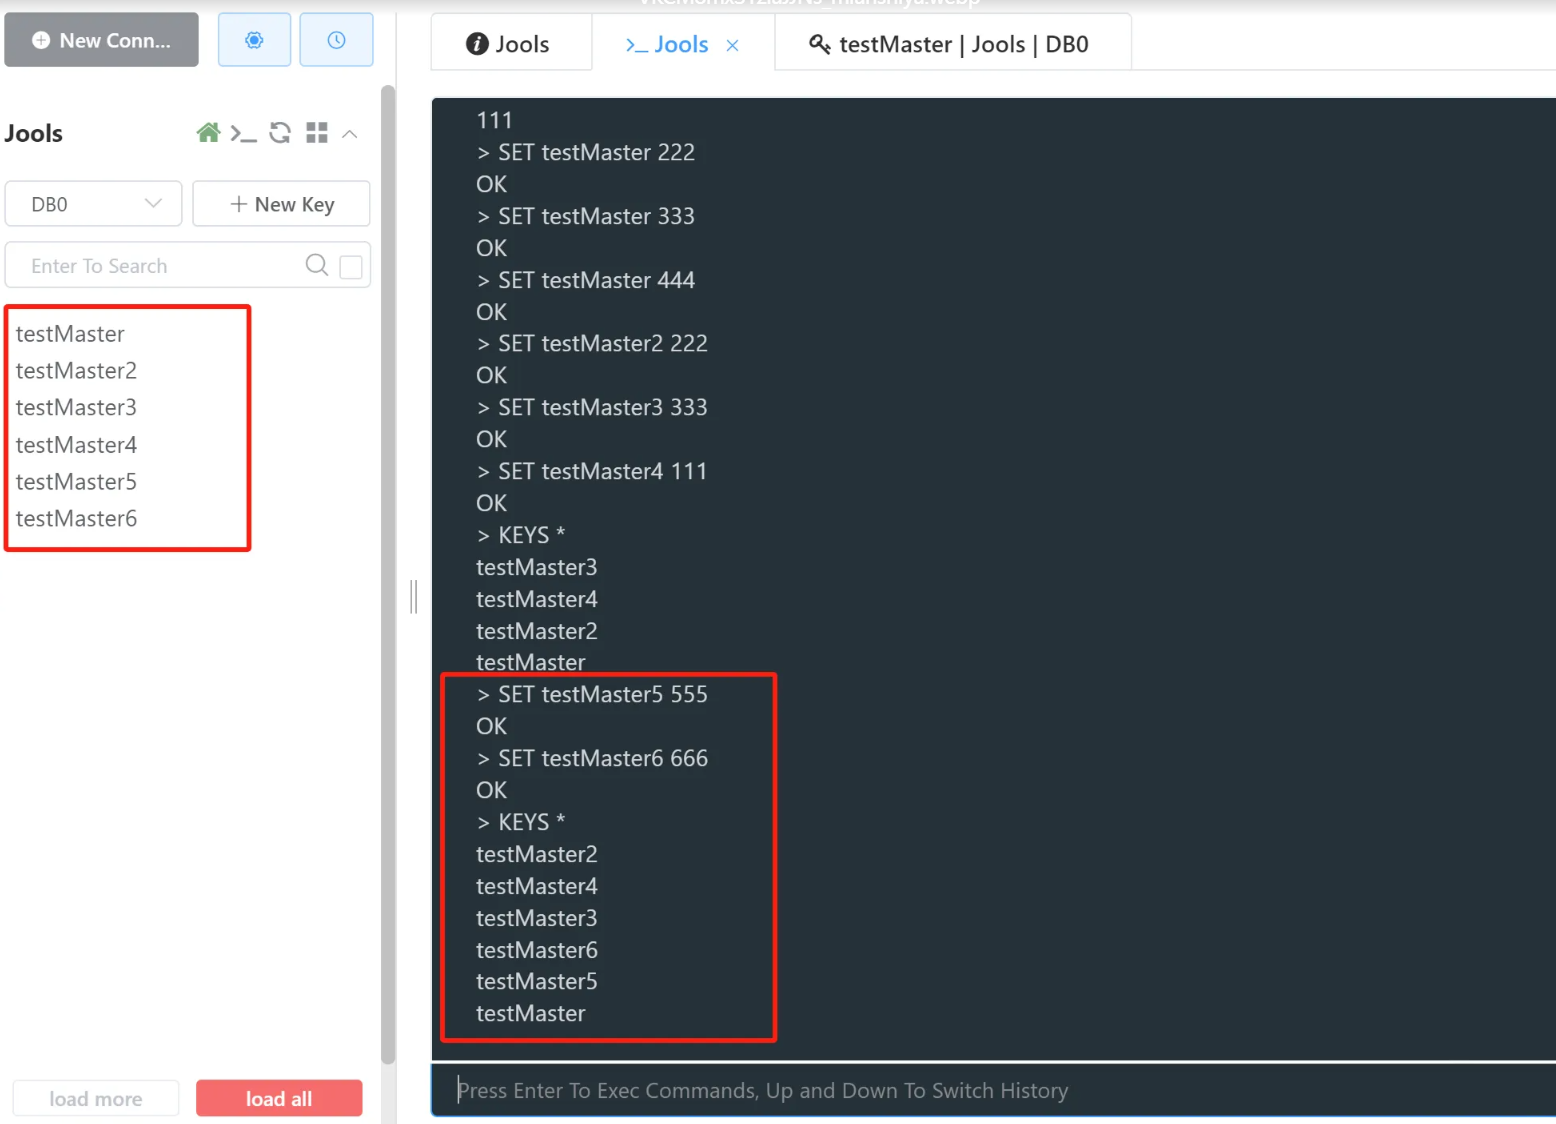
主库继续添加新的数据
当前还存活: 6379 主(Master), 6380 从(Slave) 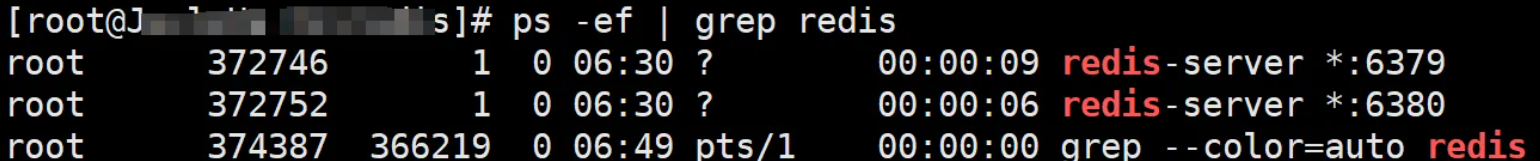
重启从库 6381 从库启动之后,默认仍然是 master 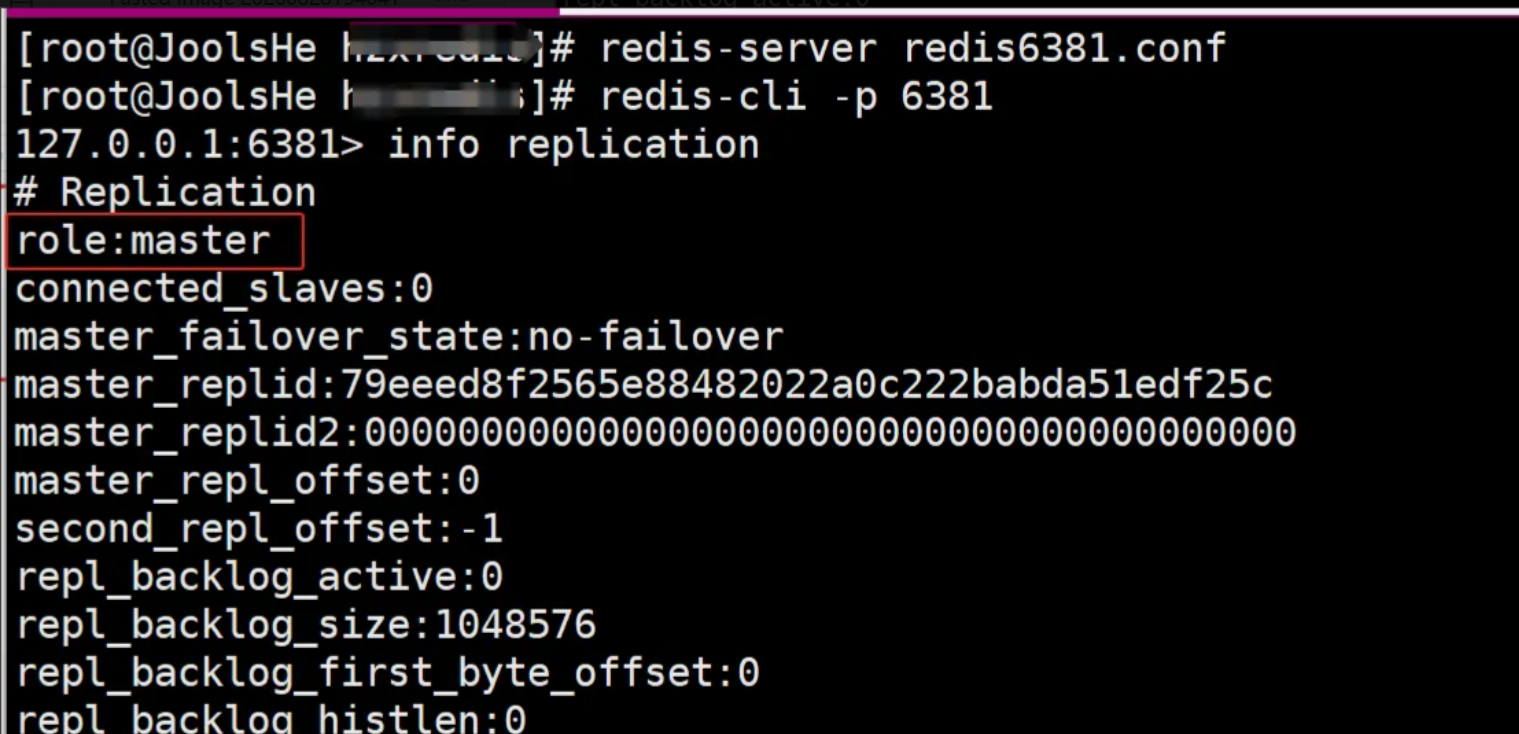
再次将其绑定 Master, 设置为从库 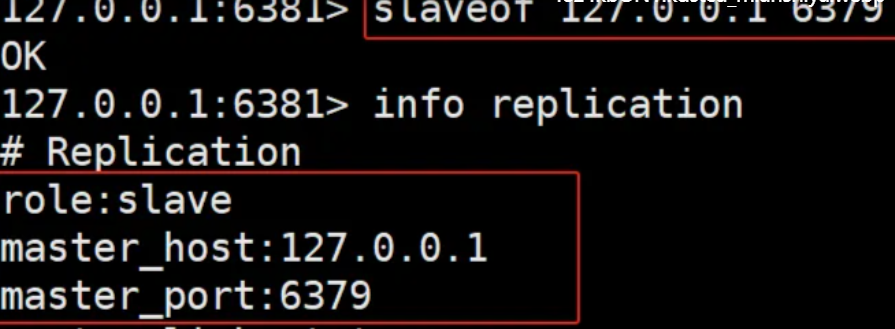
获取从库内的所有 key
- 进行全量复制,
6381从库仍然可以得到最新的数据
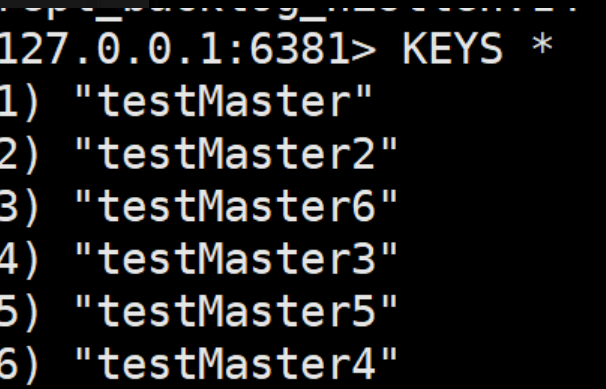
主库 Master 内此时的最新数据 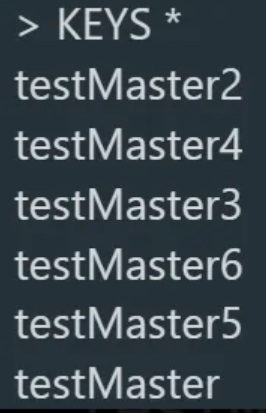
测试:Master 意外 down 后重启自动恢复 Master 地位
现象: 当 master 恢复之后,从服务器 Slave 仍然指向原来的主服务器
在 6379 主 Master 服务器内执行
SHUTDOWN
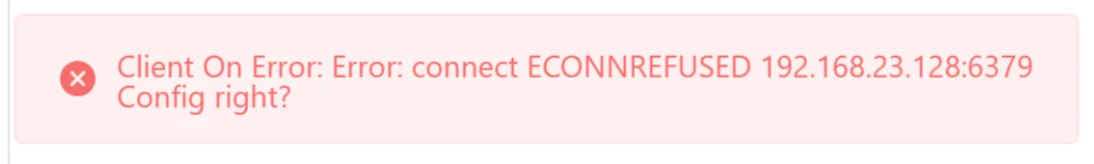
确认 Master 已经 Down 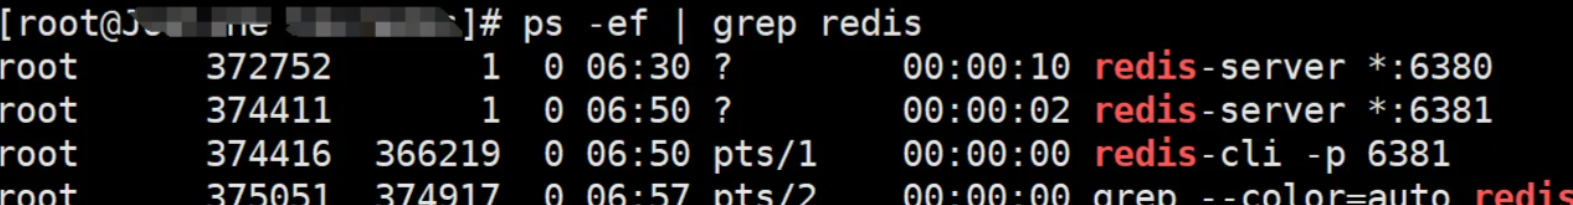
此时从服务器 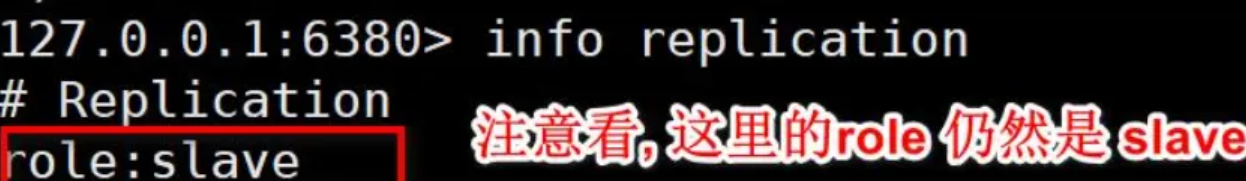
重启端口为 6379 的 Master
查看当前各个服务节点是否启动
[root@xxx]# redis-server redis6379.conf
[root@xxx]# ps -ef | grep redis
root      372752       1  0 06:30 ?        00:00:10 redis-server *:6380
root      374411       1  0 06:50 ?        00:00:03 redis-server *:6381
root      374416  366219  0 06:50 pts/1    00:00:00 redis-cli -p 6381
root      375125       1  5 06:58 ?        00:00:00 redis-server *:6379
root      375135  374917  0 06:58 pts/2    00:00:00 grep --color=auto redis
6379主服务器启动之后仍然是 master
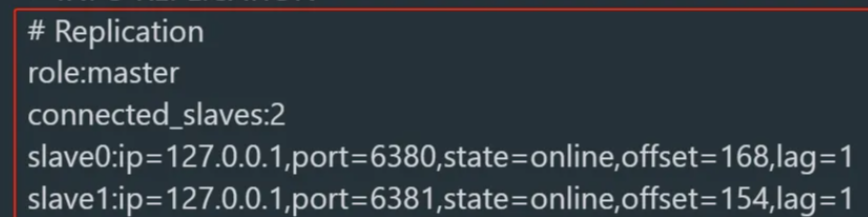
查询从服务器 Slave 信息 可以监控到主服务器已经启动 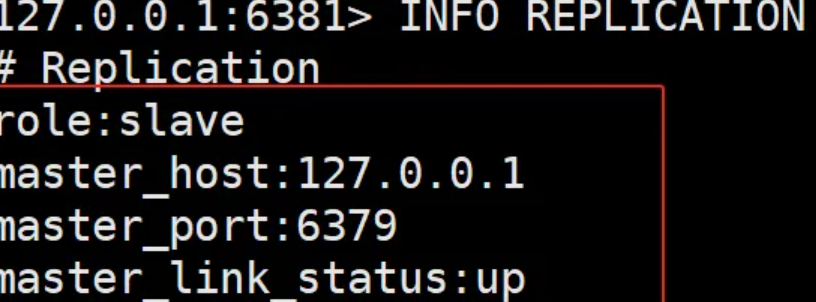 提问:从节点能不能再挂从节点?形成级联复制?
回答:可以的。从节点可以配置成另一个从节点的主节点,形成链式结构。这样做的好处是减轻主节点的复制压力。假设有 10 个从节点都直接连主节点,主节点要维护 10 个 replication buffer,要发 10 份数据。如果用级联结构,主节点只连 2 个从节点,这 2 个再各自连 4 个,主节点的压力就小多了。缺点是链路越长延迟越高,最底层的从节点数据延迟会叠加。
提问:主从复制的时候从节点还能对外提供读服务吗?
回答:默认可以,但读到的可能是旧数据。如果要求严格,可以配置 slave-serve-stale-data no,这样从节点在同步完成前拒绝所有读请求,只返回 SYNC with master in progress 错误。一般不建议这么配,会影响可用性。
提问:主节点挂了从节点会自动升级成主节点吗?
回答:不会。单纯的主从复制没有自动故障转移能力。从节点发现主节点挂了,就一直等着,不会自己升级。要实现自动切换得上哨兵或者 Redis Cluster。哨兵会监控主从节点状态,主节点挂了自动选一个从节点提升成新主节点。
提问:repl_backlog_buffer 是所有从节点共用一个,那怎么知道每个从节点同步到哪了?
回答:每个从节点会记录自己的复制偏移量 offset,主节点也记录自己当前写到哪个 offset 了。从节点重连时把自己的 offset 告诉主节点,主节点拿这个 offset 去 repl_backlog_buffer 里查。buffer 里每条数据都有对应的 offset 范围,能查到就增量同步,查不到说明数据被覆盖了就全量同步。